
DTX支援サービス
公開日: | 最終更新日:
DTX データ整備はどこから始めるべきか。データのサイロ化を解消し判断に使えるデータを揃える方法
- データ活用
- 部門連携
- スモールスタート
- 要件定義
- 導入準備


DTX(Data Throughput Transformation)における「判断に使えるデータ」とは、関係者が同じ定義で数字を確認でき、その数字を根拠として行動を決められるデータです。データが部門ごとに分断され、定義や品質が揃っていない状態では、分析結果があっても意思決定の根拠として利用できません。
この記事では、データのサイロ化やデータ品質の問題がなぜDTXを止めるのか、その構造を整理したうえで、判断に必要な指標から逆算してデータを整備する進め方を解説します。
- 目次
1. データは集まっているのに、判断に使えないのはなぜか
「売上は伸びているのか」「在庫は適正なのか」「どの顧客に優先して提案すべきか」。こうした判断に必要なデータは、多くの企業ですでに何らかのシステムに存在しています。
しかし実際には、営業は営業システム、経理は会計システム、物流は在庫システムというように、データが部門ごとに管理されているケースが少なくありません。その結果、会議のたびに複数のExcelを突き合わせたり、担当者ごとに異なる数字を参照したりする状況が発生します。
この状態では、データを集める作業に時間がかかるだけでなく、「どの数字を正しいものとして扱うべきか」という確認が必要になります。データは存在していても、判断の材料として利用できる状態にはなっていません。
データ整備の目的は、単にデータを一箇所へ集めることではありません。担当者や部門が共通の定義でデータを参照し、同じ前提で状況を把握できる状態をつくることです。
まずは「判断に使えるデータ」とはどのような状態なのかを整理してみましょう。
2. DTXは「判断に必要なデータ」から始める
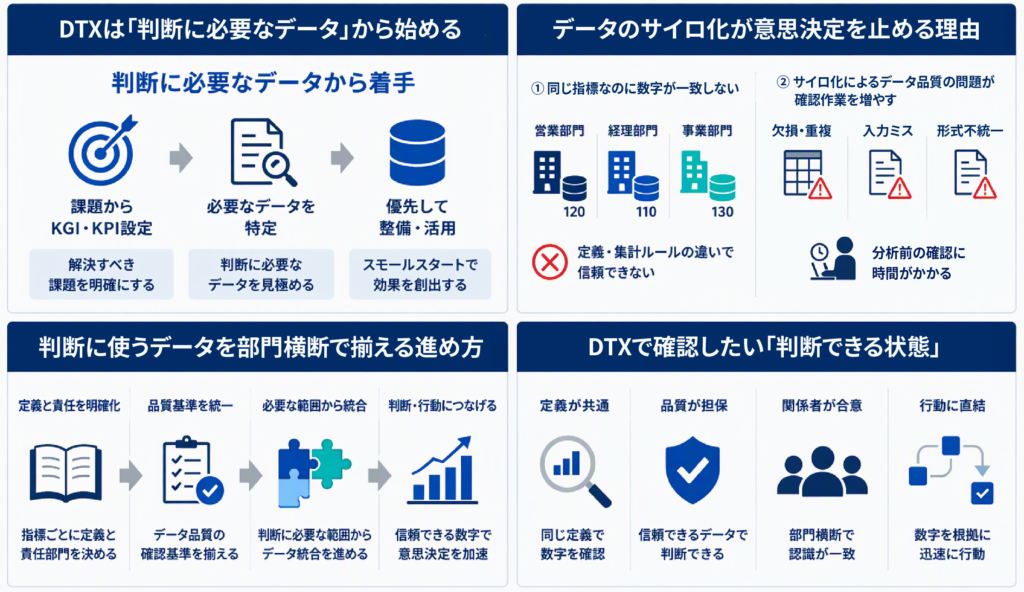
DTXのデータ整備は、全社のあらゆるデータを統合することから始めるのではなく、どの判断を変えたいのかを明確にすることから始めます。判断の対象が曖昧なままデータ統合を進めると、収集や整備そのものが目的になりやすくなります。
ZEINのDTXでは、「判断→行動→改善」の流れを設計対象としており、まず改善したい意思決定を特定する考え方を採っています。
判断したい業務課題からKGI・KPIを決める
例えば、営業部門で受注率を改善したい場合と、在庫部門で欠品を減らしたい場合では、必要となるデータは異なります。
受注率改善であれば、
- 商談数
- 提案数
- 受注数
- 失注理由
などが判断材料になります。
一方で在庫管理では、
- 在庫数量
- 出荷実績
- 発注残
- 欠品件数
などが重要になります。
この段階で必要なのは、「どのデータが存在するか」よりも、「どの判断を行うために何を確認する必要があるか」を整理することです。
判断に必要なデータを優先して特定する
全社には数百、数千のデータ項目が存在することがあります。しかし、そのすべてが意思決定に直接関係するわけではありません。
優先的に整理したいのは次のような項目です。
- 会議で継続的に利用している主要KPI
- 投資判断や施策判断の根拠になる数値
- 複数部門が共通して参照する指標
- 数字の認識違いが頻繁に発生する指標
例えば売上という指標であっても、受注時点を売上とするのか、出荷時点を売上とするのか、請求時点を売上とするのかによって数字は変わります。
まずは重要指標ごとに定義を整理し、その指標を構成するデータを確認する方が、全社統合プロジェクトを先行させるよりも実務上の判断につながりやすくなります。
3. データのサイロ化が意思決定を止める理由
データのサイロ化とは、部門やシステムごとにデータが分散し、組み合わせて利用できない状態を指します。サイロ化された環境では、必要な数字が存在していても、意思決定の根拠として利用しにくくなります。
同じ指標なのに数字が一致しない状態が発生する
会議で営業部門と経理部門がそれぞれ売上を報告したところ、数字が一致しないというケースは珍しくありません。
このとき問題になるのは計算ミスではなく、以下の違いです。
- 集計期間
- 計上タイミング
- 対象顧客範囲
- 除外条件
それぞれの部門が自部門向けに最適化したシステムを利用している場合、同じ名称の指標でも算出方法が異なることがあります。
結果として会議では分析や対策の議論よりも、「どちらの数字が正しいか」の確認に時間が使われます。 DTXが目指すのはデータを見ることではなく、データを基に判断と行動を回すことです。数字の定義が一致していない状態では、その前提が成立しません。
サイロ化によるデータ品質の問題が確認作業を増やす
データ品質とは、データが利用目的に対して十分な正確性や一貫性を持っているかという観点です。
例えば次のような状態があります。
- 顧客コードがシステムごとに異なる
- 必須項目が未入力になっている
- 同じ顧客が重複登録されている
- 更新日が管理されていない
- 商品分類のルールが統一されていない
このような状態では分析担当者が毎回データ加工を行う必要があります。
さらに、分析結果が出た後も、「欠損データはどれくらいあるのか」「この数字は最新データなのか」「除外したデータはあるのか」といった確認が発生します。判断に使う前提情報の確認に時間を取られるため、意思決定のスピードが落ちます。
また、AI活用や分析基盤の導入を進めても、入力データの品質に課題がある場合は期待した結果を評価しにくくなります。
4. 判断に使うデータを部門横断で揃える進め方
データ整備を進める際は、指標単位で定義・品質・責任を整理します。
重要なのは、誰が見ても同じ数字を確認できる状態を作ることです。
指標ごとに定義と責任部門を決める
まず主要なKPIについて、次の内容を整理します。
| 確認項目 | 内容 |
|---|---|
| 指標名 | 何を測定するのか |
| 計算方法 | 算出式は何か |
| 利用目的 | どの判断に使うか |
| データソース | どのシステムを利用するか |
| 責任部門 | 定義変更や品質確認を誰が行うか |
例えば受注率を管理する場合でも、営業企画部門が定義管理を担当し、営業システムからデータを取得するといった役割を明確にします。
責任主体が不明確なままでは、定義変更時や品質問題発生時の判断が遅れます。
データ品質の確認基準を揃える
品質確認は、データ基盤構築後ではなく、指標を利用する前提として実施します。
確認項目の例は次の通りです。
- 欠損データは許容範囲内か
- 重複データは存在しないか
- 更新頻度は利用目的に合っているか
- 集計粒度は一致しているか
- コード体系は統一されているか
例えば日次判断に利用するデータであれば、週次更新では利用できません。
品質の評価は「良いデータかどうか」ではなく、「その判断に利用できるかどうか」で行います。
判断に必要な範囲からデータ統合を進める
データ統合では、対象範囲を限定することが重要です。
例えば売上予測の精度向上を目的とする場合、
- 営業管理システム
- 顧客管理システム
- 受注管理システム
の連携が優先対象になるかもしれません。
DTX支援でも、最初から全社を対象とするのではなく、影響の大きい意思決定から着手するスモールスタートの考え方が示されています。
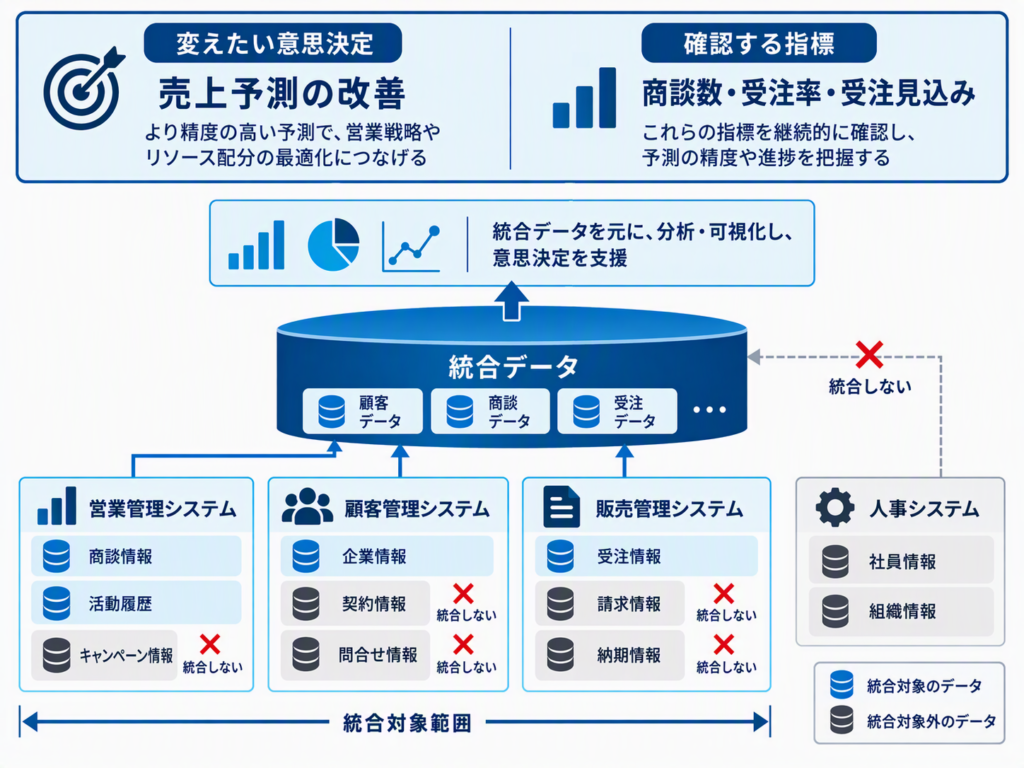
当社では、データ整備を検討する際に、まず対象となる意思決定と利用指標を整理し、その指標に関係するシステム、データ量、品質課題、運用主体を確認します。その結果を基に、統合対象や整備の優先順位を決定します。
5. DTXで確認したい「判断できる状態」
DTXの目的はデータを集めることではありません。意思決定に必要な情報を共通の基準で確認し、判断と行動につなげることです。
データ整備が進んだ状態では、次の内容を説明できます。
- 指標の定義が文書化されている
- 数字の算出元を説明できる
- データ品質の確認方法が決まっている
- 問題発生時の責任部門が明確である
- 会議で数字の正しさではなく対応策を議論できる
これらが揃って初めて、分析結果を意思決定に利用できる状態になります。
6. 相談・お問い合わせ
「部門ごとに数字が合わない」「どこからデータ整備を始めればよいか分からない」「DWH導入を検討しているが、統合対象を決められない」といった状況では、システム構成だけでなく、意思決定に利用する指標やデータ品質の観点から整理する必要があります。
当社では、利用中のシステムやデータの状況を確認しながら、
- 優先して整備すべき指標は何か
- どのデータを統合対象とするか
- 品質上の課題はどこにあるか
- 段階的に進める場合の優先順位はどうするか
といった論点の整理をご支援しています。